近日,北航自旋芯片与技术全国重点实验室赵巍胜教授、张悦教授团队成员王进凯副研究员在高性能人工智能芯片研究领域取得重要进展,提出了一种面向边缘神经网络推理的阵列划分多宏存算一体(Array Partition Multi-macro Computing-in-Memory,APM-CIM)芯片。该研究通过电路、架构与系统协同优化,突破传统存算一体架构在计算效率、多宏并行以及数据传输方面的瓶颈,实现了高性能、低功耗的边缘神经网络推理加速。相关成果以APM-CIM: An Array Partition Multi-macro CIM System with Dynamic Sparse Approximation for Neural Network Edge Applications为题,发表于集成电路设计领域国际顶级期刊IEEE Journal of Solid-State Circuits(JSSC)。该成果是北航国新院首篇发表于JSSC的研究论文,实现了国新院在集成电路设计领域的全新突破。
原文链接:https://ieeexplore.ieee.org/abstract/document/11649852
北航集成电路科学与工程学院博士生张伯均、北航国新院王进凯副研究员为论文共同第一作者;北航国新院王进凯副研究员、北航集成电路科学与工程学院张悦教授为论文共同通讯作者,北航国新院为论文第一完成单位。上述工作得到了国家重点研发计划、浙江省自然科学基金等项目支持。
JSSC是IEEE固态电路学会(IEEE Solid-State Circuits Society, SSCS)旗下的旗舰期刊,创刊于1966年,是国际集成电路设计领域最具影响力的学术期刊之一。JSSC聚焦固态集成电路与晶体管级电路设计,涵盖模拟与混合信号、数字电路、存储器、人工智能加速器及存算一体等方向,并特别强调电路创新、芯片实现与实验测试验证,被誉为“集成电路设计领域的喜马拉雅山”。期刊论文通常要求具有较强的电路级创新性和完整的芯片实测结果,在学术界和产业界均具有较高认可度。
研究背景
随着人工智能算法快速发展,神经网络模型规模不断增长,边缘智能设备对计算性能和能效提出了更高要求。传统冯·诺依曼架构中存储与计算分离导致的数据搬移开销,成为限制人工智能芯片进一步发展的重要因素。存算一体技术通过将计算操作直接融合于存储阵列内部,有望减少数据传输并提升计算效率。然而,现有存算一体系统仍面临计算周期随数据精度增加、多宏系统输入带宽受限以及系统级数据调度效率不足等挑战。
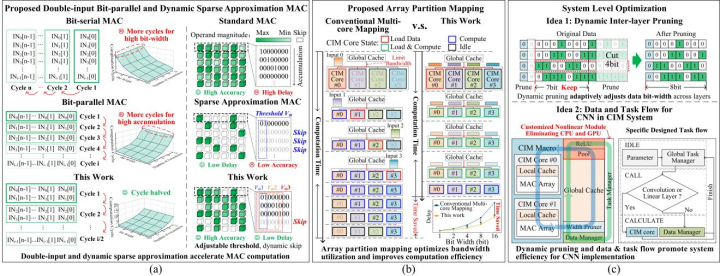
△ 图1.边缘端人工智能芯片挑战及本工作创新点
针对上述问题,研究团队提出APM-CIM芯片,通过电路、架构与系统协同设计,提升存算单元的计算效率、多宏架构的并行能力以及完整神经网络推理过程中的系统能效。
研究亮点
一、双输入位并行计算与动态稀疏感知
在电路层面,团队提出双输入位并行计算机制,在每个计算周期内同时处理两组输入—权重数据。不同于传统位串行存算电路逐比特输入数据,该机制直接传输完整精度的输入数据,并利用两路独立计算通路完成两组输入—权重乘加运算,再通过共享加法器形成局部累加结果。与单输入位并行方案相比,双输入机制可将完成相同规模乘加运算所需的计算周期减少约一半,并提高缓存接口在数据加载过程中的有效利用率。为适配双输入计算,团队进一步优化8T SRAM存储阵列,在同一列中配置两条独立的数据读取通路,使相邻存储单元能够在单次阵列访问中同步读出两组权重数据,在较小电路开销下为双输入乘加计算提供数据支撑。神经网络输入特征和权重参数中还存在大量数值较小、对最终推理结果贡献有限的数据。传统存算一体电路仍会对这些数据执行完整乘加运算,造成不必要的计算延迟和能量消耗。为此,团队提出动态稀疏感知机制,通过检测输入和权重数据的高位特征,在线判断其数值大小。当一组输入和权重均低于设定阈值时,系统将其识别为低贡献数据并跳过相应乘加操作。与采用固定阈值的传统近似计算方法相比,该机制支持多档动态稀疏阈值,可根据不同神经网络、不同网络层以及不同应用场景的精度和性能需求灵活调整。在精度敏感任务中可采用较低阈值或关闭近似计算,在延迟和能耗敏感任务中则可提高稀疏阈值,从而在推理精度、计算延迟和能量效率之间实现动态权衡。
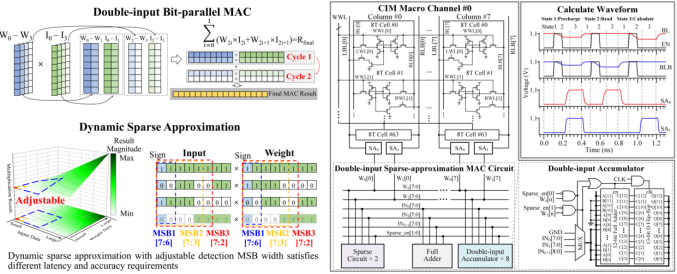
△ 图2.双输入位并行计算、动态稀疏感知机制及其电路结构
二、阵列划分多宏拆分映射,提升带宽利用率
在架构层面,团队针对多宏存算系统中的输入带宽瓶颈,提出阵列划分多宏拆分映射方法。传统映射方式需要将完整输入矩阵预先加载至存算宏的本地寄存器,只有在全部输入数据准备完成后才能启动计算,数据加载与阵列计算呈串行关系。在多宏系统中,由于全局缓存带宽有限,各存算宏还需要依次完成数据加载,导致大量存算宏处于等待状态。
研究团队所提出的阵列划分方法沿阵列行方向对输入数据和权重映射进行拆分,将完整输入矩阵划分为多个较小的数据分区。每个存算宏只需接收到当前计算所需的部分输入数据即可启动计算,无须等待完整输入矩阵全部加载。阵列处理当前数据分区的同时,全局缓存可同步加载下一数据分区,从而将原本串行执行的数据加载与计算过程转变为流水化重叠执行。该方法应用于多宏系统后,多个存算宏可在有限缓存带宽下同步接收小规模输入分区,并利用已经加载的数据开展并行计算,减少因数据等待造成的计算资源空闲。测试结果表明,阵列划分映射可使单宏和多宏系统的计算延迟降低15%~37.5%,有效提升缓存带宽利用率和多宏并行计算能力。
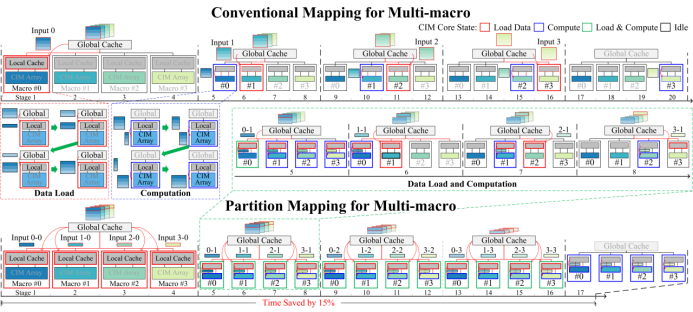
△ 图3.阵列划分多宏拆分映射方案
三、动态位宽裁剪与数据任务协同管理
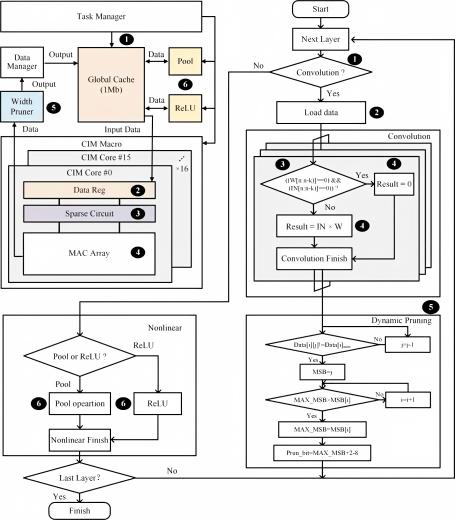
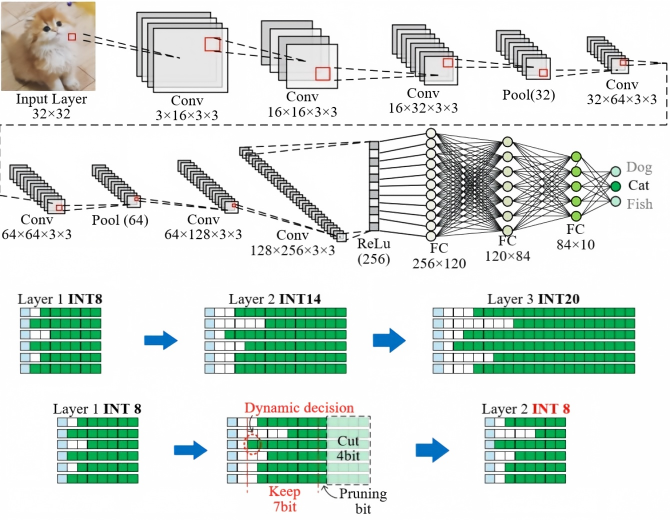
在系统层面,团队面向完整卷积神经网络推理流程,设计了动态位宽裁剪以及数据与任务协同管理机制。在神经网络卷积运算中,INT8输入和权重经过多次乘加后,中间结果位宽可能扩展至21 bit。若将高位宽中间结果直接传输和存储,将增加全局缓存容量、数据总线宽度以及后续计算模块的硬件开销;若采用固定位置截取,又可能因不同网络层的数据分布差异而出现溢出、下溢或有效信息损失。为解决这一问题,团队提出层级动态位宽裁剪方法。该方法首先分析当前网络层全部计算结果的有效最高位置,据此确定能够覆盖主要数据动态范围的最优8 bit窗口,再对该层输出执行统一移位与裁剪。与固定位置截取相比,该方法能够根据不同网络层的实际数据范围动态调整裁剪位置,在降低层间数据位宽和缓存访问开销的同时,尽可能保留对推理精度具有重要作用的信息。
△ 图4.动态位宽裁剪和计算任务调度方案
团队还设计了数据管理器和任务管理器,对神经网络不同类型的计算任务进行统一调度。任务管理器根据网络层类型和配置信息,区分卷积、全连接等线性运算与ReLU、池化等非线性运算,并将任务分配至相应计算模块;数据管理器负责输入数据加载、动态稀疏判断、乘加结果裁剪以及层间数据存储,使线性计算、非线性处理和数据传输在片上有序衔接。通过动态位宽裁剪、任务分类调度和片上数据流优化,APM-CIM减少了存算宏、全局缓存和外围功能模块之间不必要的数据交互,降低了存算一体芯片由宏单元向完整系统扩展时的性能损失。
四、40 nm芯片验证,实现67.63 TOPS/W系统能效
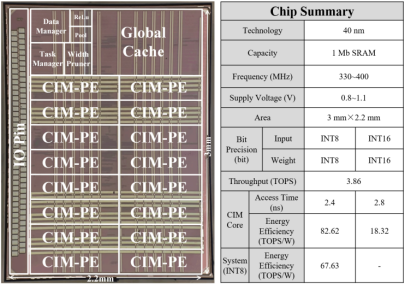
基于上述技术,团队采用40 nm CMOS工艺完成了APM-CIM芯片研制与测试。芯片集成多个全数字SRAM存算宏、全局缓存、局部寄存器、动态位宽裁剪模块、ReLU与池化模块,以及数据和任务管理单元,支持INT8和INT16神经网络计算。
△ 图5.芯片Die与性能表
实测结果表明,芯片在INT8模式下峰值计算性能达到3.86 TOPS,存算宏能效达到82.62 TOPS/W,完整系统能效达到67.63 TOPS/W。由存算宏扩展至系统后,能效损失仅为18.14%。在神经网络测试中,芯片支持VGG、MobileNet和ResNet-18等典型卷积神经网络模型。其中,在CIFAR-10数据集上执行VGG模型推理时,实现89.95%的分类准确率、2.13 ms的推理延迟和34.0 mW的功耗,验证了该芯片面向边缘智能应用的高性能、低功耗推理能力。
总结
该研究面向边缘神经网络推理需求,通过双输入位并行与动态稀疏感知、阵列划分多宏映射以及数据与任务协同管理,形成了从电路、架构到系统的跨层协同优化方案,并完成40 nm CMOS芯片研制与测试,在INT8模式下实现67.63 TOPS/W的系统能效,验证了其在VGG、MobileNet和ResNet等典型神经网络模型中的应用能力。作为北航国新院首篇发表于JSSC的研究成果,该工作标志着国新院在高能效存算一体芯片设计领域取得了重要突破,体现了国新院在高性能人工智能芯片研究领域的持续科研积累。
(审核:董卓宁 陶来发 林晓阳)




 最新动态